新しいAIが毎週のように発表され、「結局いま一番賢いのはClaudeとGPTとGeminiのどれなの?」と迷う場面が増えています。SNSの評判だけでは、文章がうまいのか、プログラムに強いのか、値段に見合うのかが見えにくいものです。
そこで今回は、2026年11月19日時点で注目されている有名AIベンチマーク8種類の最新結果と感想を一覧にまとめました。各テストの「何を測っているか」「最新の結果」「第三者目線の感想」を順番に並べているので、用途に合うAIを選ぶ参考にしてください。
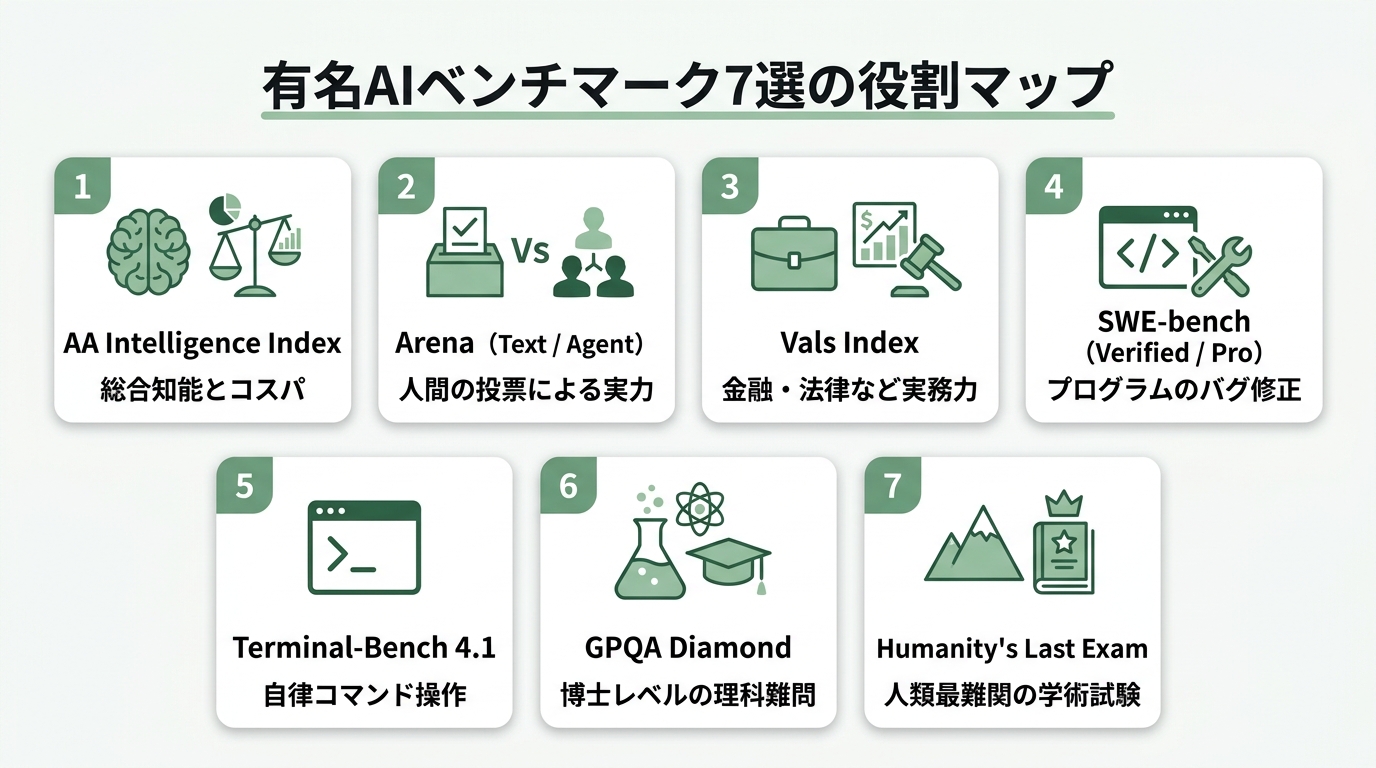
主要8ベンチマークの結果早見表(2026年11月時点)
まずは全体像を一目でつかめるよう、8つのベンチマークと最新のトップ帯を一覧表に整理しました。
| ベンチマーク名 | 測る能力 | 最新のトップ結果(2026年11月) |
|---|---|---|
| Artificial Analysis Intelligence Index | 総合知能・コスト効率 | 1位 Claude Fable 5.2(64.6〜65)/ 2位 GPT-6.2 Astra(62.1)/ 3位 Gemini 4 Neon(61) |
| Arena(Agent Arena Index / Text) | 自律作業・人間の好み | Agent:1位 Claude Fable 5.2(1,448)/ 2位 Claude Opus 5.5(1,336)/ 3位 Gemini 4 Neon(1,333) |
| Vals Index | 金融・法律など実務力 | 1位 Claude Fable 5.2(71.31%)/ 2位 Gemini 4 Neon(70.87%)/ 3位 GPT-6.2 Astra系(約67.66%) |
| SWE-bench(Verified / Pro) | プログラムのバグ修正 | Verified:Claude Fable 5・Opus系が95〜97% / Pro:上位でも23〜50%程度 |
| Terminal-Bench 4.1 / Coding Agent Index | コマンド操作・自律開発 | TB 4.1:Copilot Fusion(71.2%)、Claude Opus 5.5 / Fable 5.2(65.76%)/ Coding Agent:Gemini 4 Neon(58.6) |
| GPQA Diamond | 博士レベルの理科難問 | GPT-6.2 Astra(約97%)/ Gemini 4 Argon・Neon(96.4〜96.5%) |
| Humanity’s Last Exam(HLE) | 人類最難関の学術試験 | Claude Fable 5.2(74.2%)/ GPT-6 Astra・6.2系(条件により54.8%前後) |
| Artificial Analysis Image Arena | 画像生成・画像編集 | 生成:GPT Image 2.6 Sunburst(1,261 Elo)/ 編集:MAI-Image-2.7(1,215 Elo) |
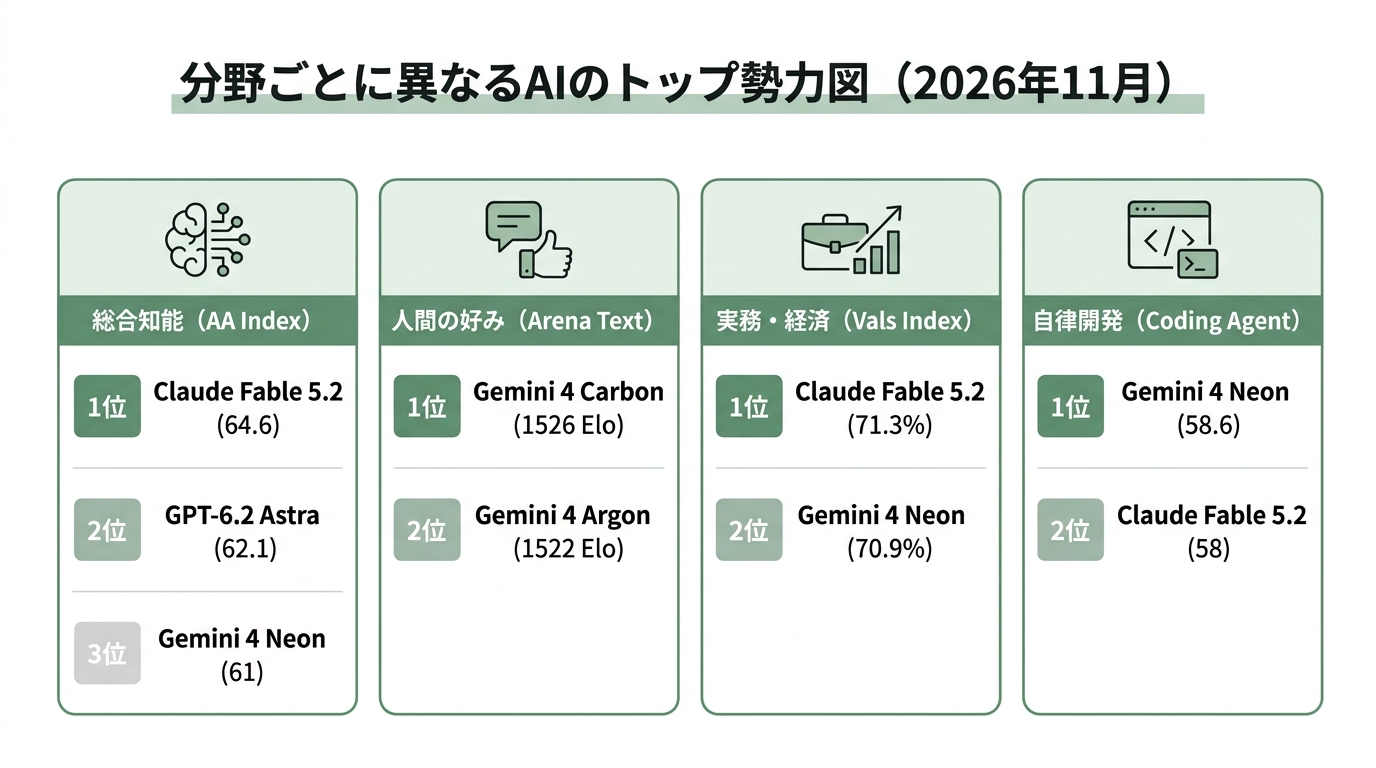
「全分野で圧倒的1位」はおらず、
用途ごとにトップが入れ替わる時代
1. Artificial Analysis Intelligence Index
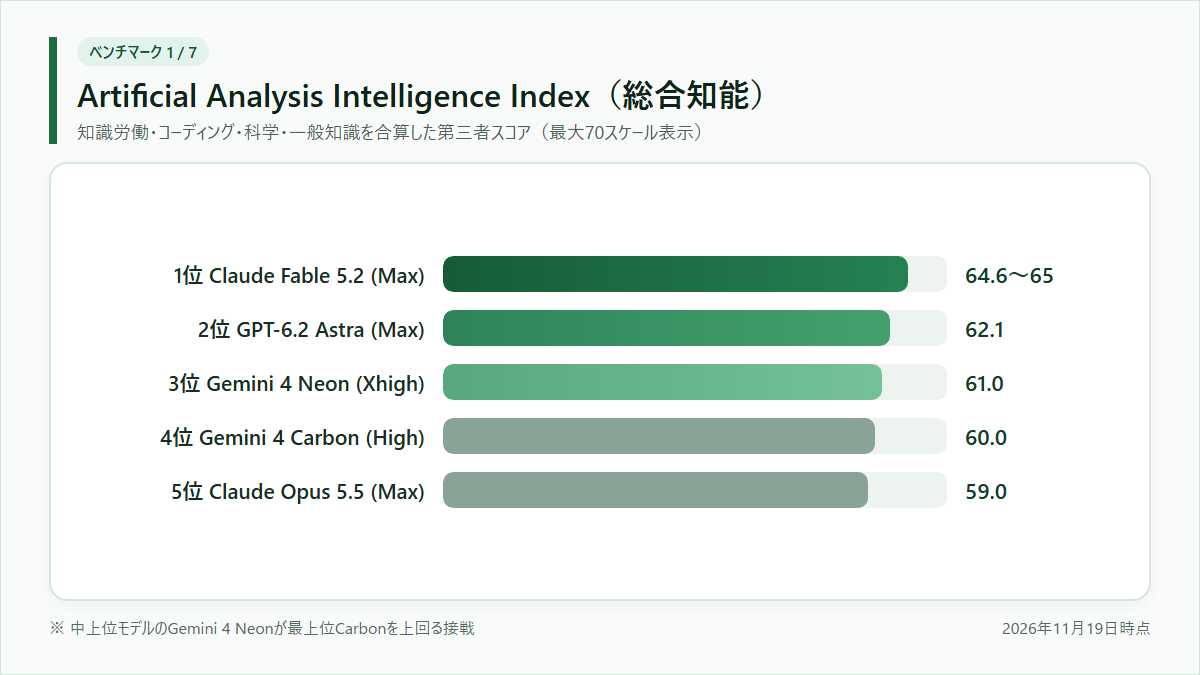
知識労働、プログラミング、科学、一般知識のテストを合算し、AIの総合的な賢さと1作業あたりの料金や速さを比べる第三者の代表指標です。
結果
- 1位:Claude Fable 5.2(Max / Xhigh) ― スコア 64.6〜65
- 2位:GPT-6.2 Astra(Max) ― スコア 62.1
- 3位:Gemini 4 Neon(Xhigh) ― スコア 61(最上位の Gemini 4 Carbon は 60)
- 4位:Claude Opus 5.5(Max) ― スコア 59
感想
Anthropic・OpenAI・Googleの3社が数ポイント差で並ぶ大接戦です。特に面白いのは、中上位モデルとして出たGemini 4 Neonが、同じ会社の最上位モデルCarbonをわずかに上回るスコアを出した点です。「一番大きくて高いモデルが常にトップ」とは限らなくなってきたのがよく分かります。
2. Arena(Agent Arena Index / 旧LMSYS Chatbot Arena)
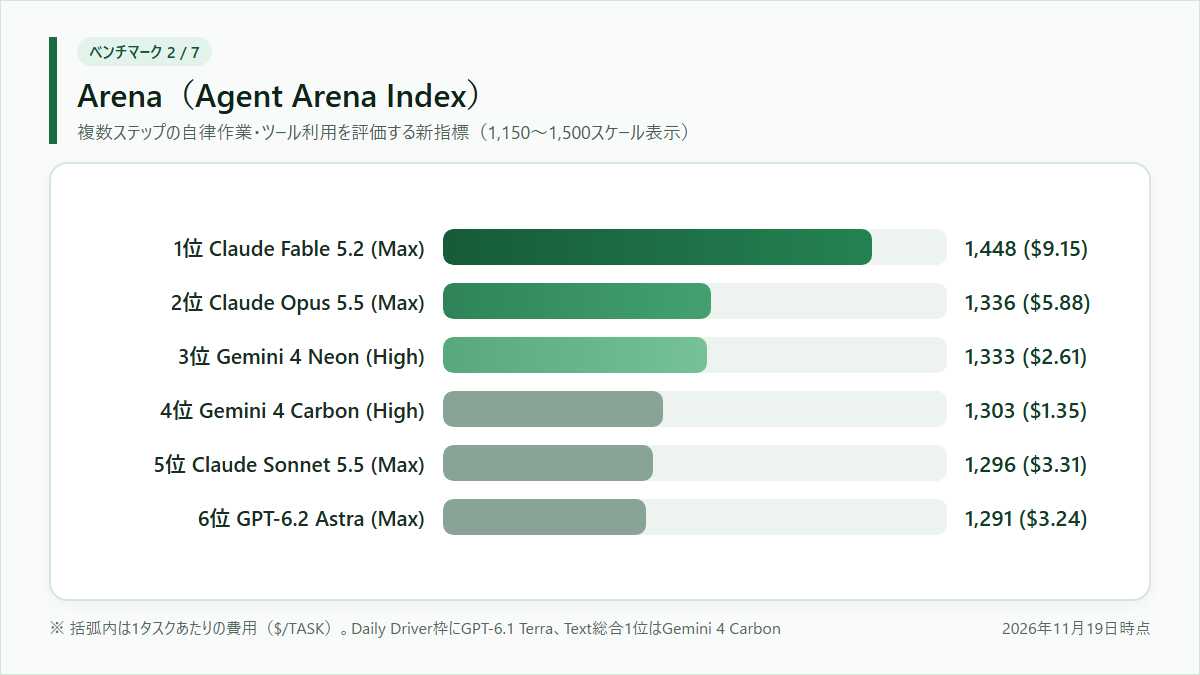
現在のArena(arena.ai)では、複数ステップの道具使いや自律作業を実測する新しい主軸指標「Agent Arena Index」が大きく掲げられています。あわせて、AIの名前を隠した状態で人間が2つの返答を読み比べる従来からの人気投票「Text(累計900万票以上)」も公開されています。
結果
- Agent Arena Index(最新主軸指標):1位 Claude Fable 5.2 (Max)(Index 1,448/1作業あたり $9.15・19.5分)、2位 Claude Opus 5.5 (Max)(1,336/$5.88・17.2分)、3位 Gemini 4 Neon (High)(1,333/$2.61・8.4分)、4位 Gemini 4 Carbon (High)(1,303/$1.35・9.5分)、5位 Claude Sonnet 5.5 (Max)(1,296/$3.31)、6位 GPT-6.2 Astra (Max)(1,291/$3.24)、7位 GPT-6 Astra (Max)(1,282/$4.89)
- Daily Driver・Efficient枠(コスパ重視):普段使い向けのDaily Driverに GPT-6.1 Terra (Max)、軽量高効率のEfficientに Metaの Muse Ember が選出
- 補足:Text総合(従来の会話投票):1位 Gemini 4 Carbon(約1526 Elo)、2位 Gemini 4 Argon(約1522 Elo)、3位 Muse Wonder(約1511 Elo)、4位 Claude Opus 5.5(約1507 Elo)
感想
Agent Arena Indexを見ると、1位のClaude Fable 5.2が2位以下に112ポイント差を付けて抜けていますが、1タスクあたり約9.15ドル・所要時間19.5分とコストも時間もかなり重めです。一方、3位のGemini 4 Neonは2.61ドル・8.4分と約3分の1以下の費用・半分の時間で2位(1,336)に迫る1,333を出しており、実用上のバランスが非常に光ります。会話の好み(Text)だけでなく「お金と時間をかけてどこまで仕事をやり切るか」が見えるようになったのは大きな進歩です。
3. Vals Index
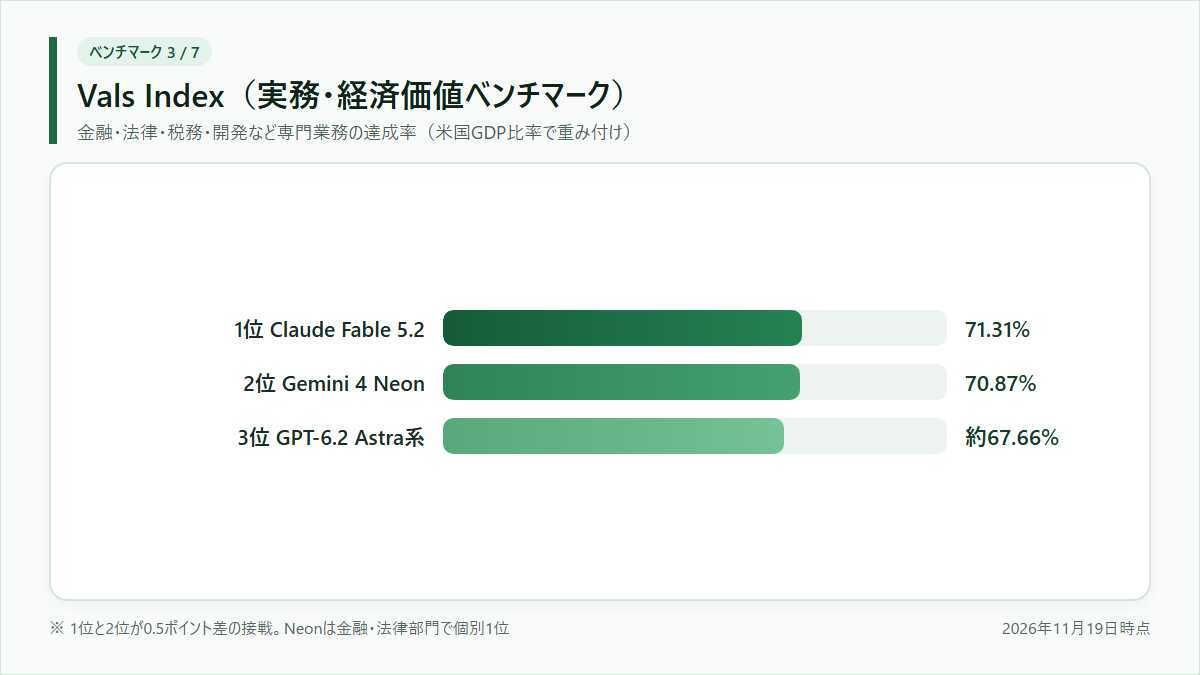
金融、会計、法律、税務、プログラミングなど、実際のビジネスでお金を生む専門作業をどれだけこなせるかを、米国のGDP(産業の重み)に合わせて計算する実務寄りのテストです。
結果
- 1位:Claude Fable 5.2 ― 71.31%
- 2位:Gemini 4 Neon ― 70.87%(金融や法律の個別部門では1位)
- 3位:GPT-6.2 Astra系 ― 約67.66%
感想
学校のようなテストではなく「仕事で使えるか」に近い指標で、1位と2位がわずか0.5ポイント差に迫っています。Gemini 4 Neonが金融・法律の部門でトップを取っており、コストを抑えつつ実務で戦えるモデルが増えたのは使う側にとって心強い流れです。
4. SWE-bench(Verified / Pro)
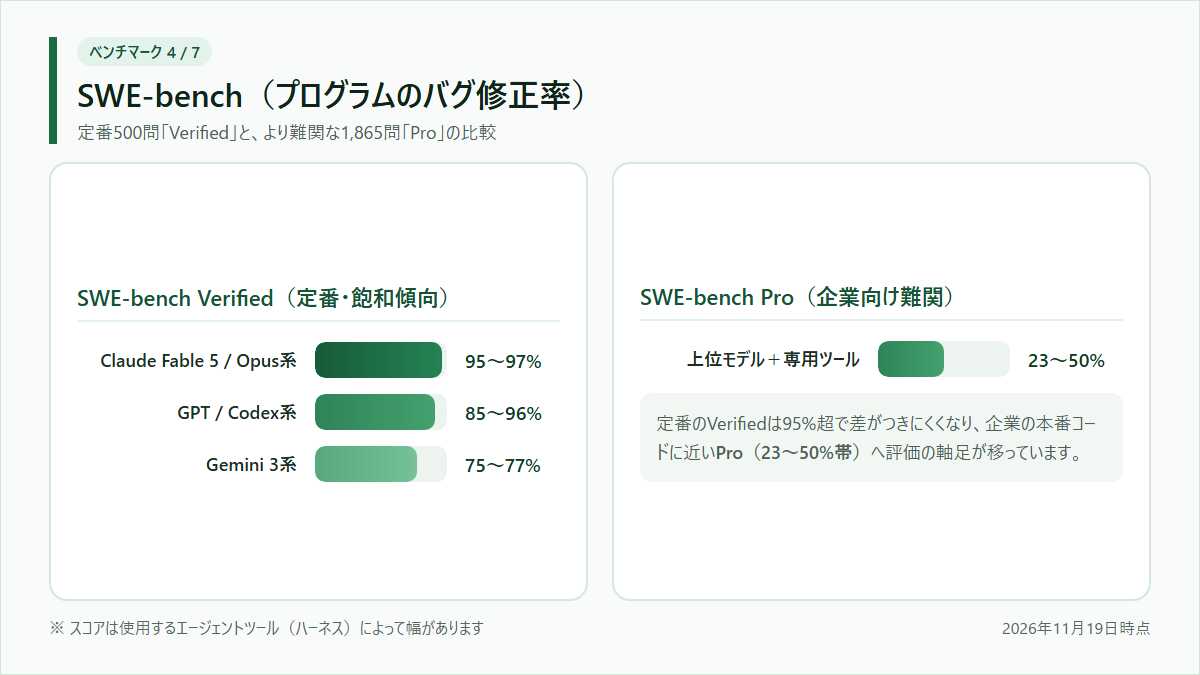
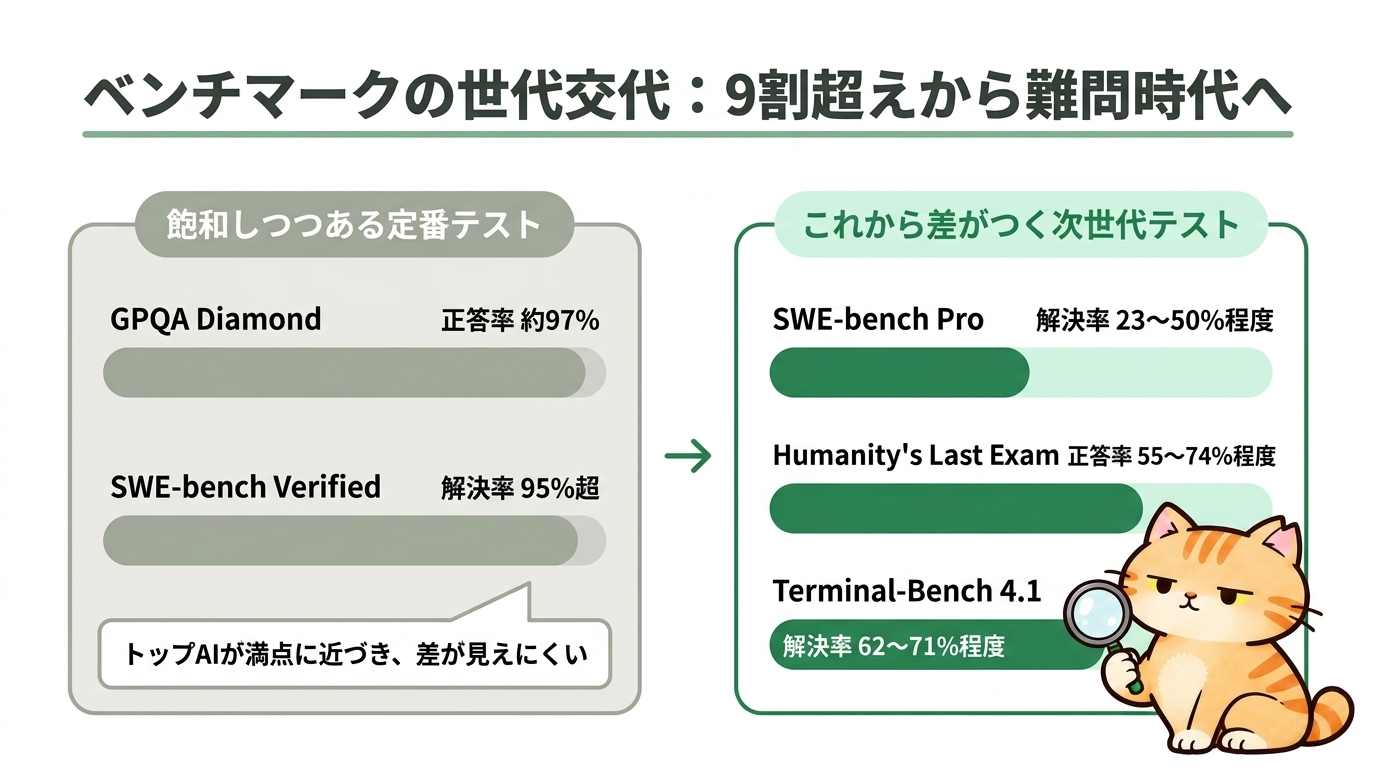
実際のプログラムに潜むバグをAIが自力で直し、テストを通せるかを測る定番ベンチマークです。500問の「Verified」が有名ですが、最近はより難しく汚染対策もした1,865問の「SWE-bench Pro」へ軸足が移っています。
結果
- SWE-bench Verified:Claude Fable 5 / Opus系が 95〜97%前後、GPT / Codex系が 85〜96%台、Gemini 3系が 75〜77%台
- SWE-bench Pro:上位モデルと専用ツールの組み合わせでも 23〜50%程度
感想
定番のVerifiedは上位勢が95%を超え、正直なところ「天井にぶつかって差が見えにくい状態」に入っています。企業の本番コードに近いSWE-bench Proではまだ半分も解けていないため、開発力を比べるならこれからはProの数字を見る方が現実的です。
5. Terminal-Bench 4.1 & Coding Agent Index
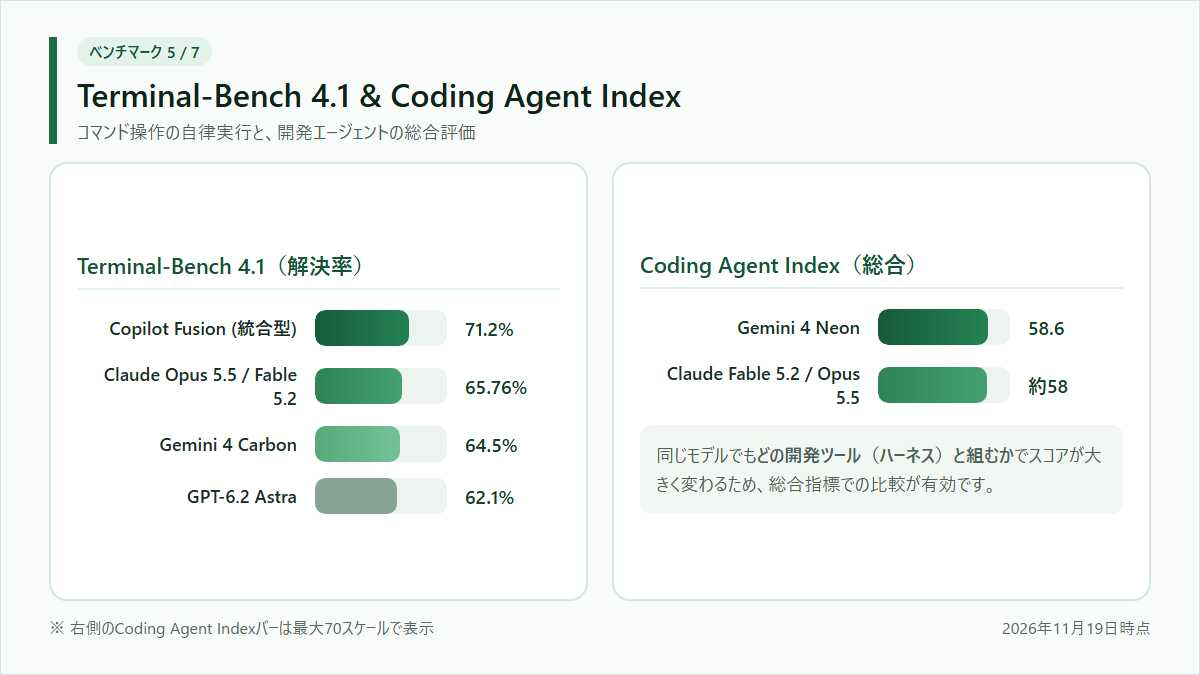
Terminal-Bench 4.1は、黒い画面(ターミナル)の中で環境構築やデバッグなど66個の作業を自律でやり切るテストです。Artificial AnalysisのCoding Agent Indexは、そこに難問コードや知識問題も合わせた総合ランキングです。
結果
- Terminal-Bench 4.1:全体首位は GitHubの Copilot Fusion(約71.2%)。モデル×公式ツールでは Claude Opus 5.5 / Fable 5.2(各65.76%)、Gemini 4 Carbon(64.5%)、GPT-6.2 Astra(62.1%)
- Coding Agent Index(総合):1位 Gemini 4 Neon(約58.6)、続いて Claude Fable 5.2 / Opus 5.5(約58)
感想
この結果から見えてくるのは、「AIモデル本体の賢さ」だけでなく「それを動かす開発ツール(ハーネス)の出来」でスコアが大きく変わるということです。同じモデルでもツール次第で成績が上下するため、モデル単体の数字だけで決めない方が安全です。
6. GPQA Diamond
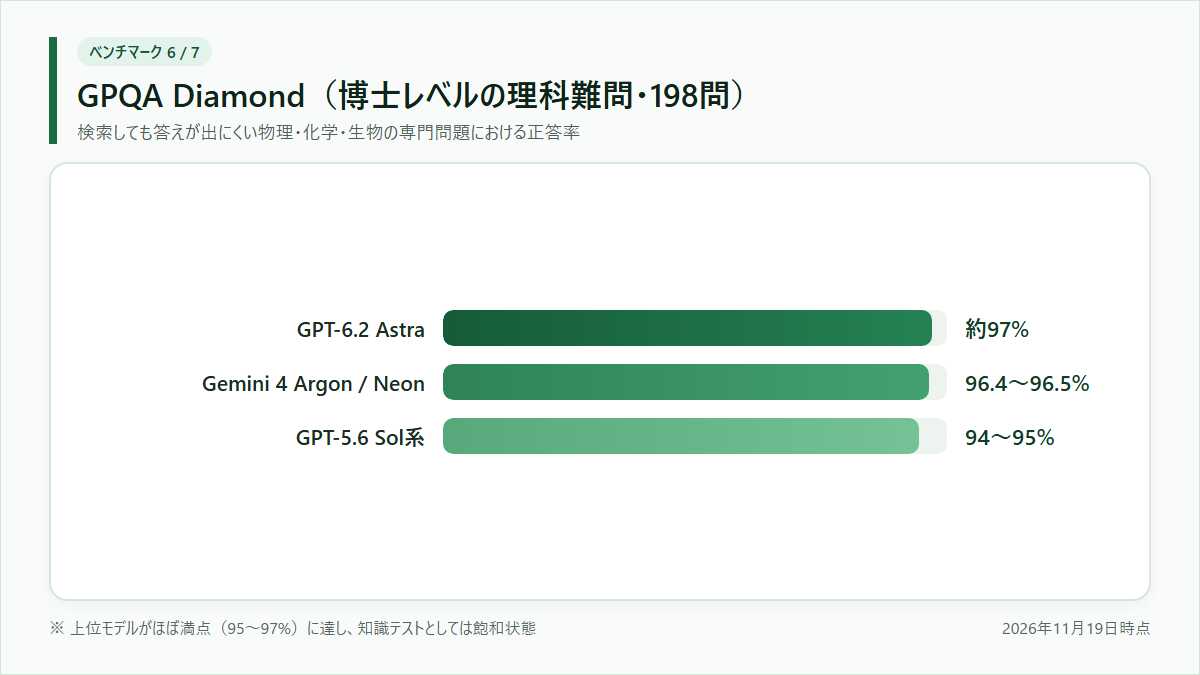
Web検索をしても答えが出にくい、博士課程レベルの物理・化学・生物の難問198問を集めたテストです。
結果
- GPT-6.2 Astra ― 約97%
- Gemini 4 Argon / Neon ― 96.4〜96.5%
- GPT-5.6 Sol系 ― 94〜95%台
感想
かつてはAIにとって超難関だったテストですが、いまや上位モデルが95〜97%とほぼ満点に近い数字を出しています。理系の専門知識を問うテストとしては役割を終えつつあり、この数字だけでモデルを選ぶ意味は薄れています。
7. Humanity’s Last Exam(HLE)
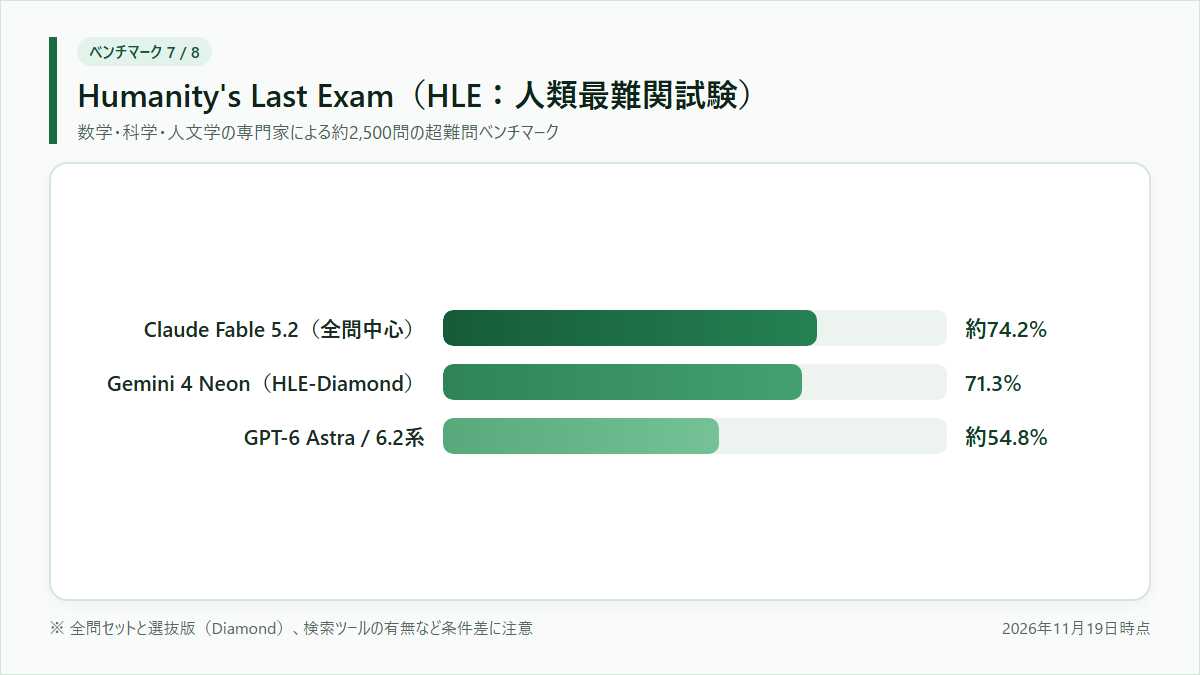
GPQAなどの定番テストが満点近くになったことを受けて作られた、数学・科学・人文学の専門家による約2,500問の超難問集です。
結果
- Claude Fable 5.2 ― 約74.2%(全問・テキスト中心の条件)
- GPT-6 Astra / 6.2系 ― 条件により 54.8%前後
- HLE-Diamond(選抜版) ― Gemini 4 Neon が 71.3% など
感想
他のテストで9割超えが並ぶなか、まだ5〜7割台にとどまっているため、最先端AIの「本当の限界」が見えやすい貴重なテストです。ただし、Web検索を使うかどうかや、全問か選抜版(Diamond)かで数字が大きく変わるため、横並びで比べるときは測定条件の確認が欠かせません。
8. Artificial Analysis Image Arena(画像生成・編集)
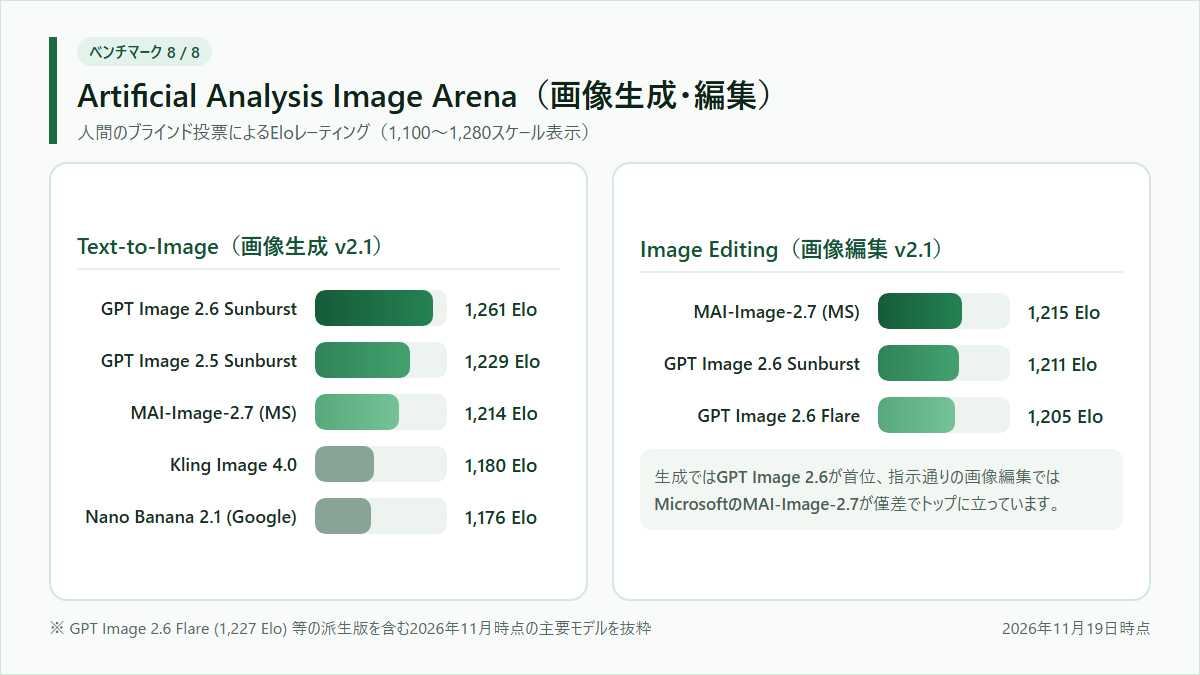
文章やプログラムだけでなく、画像を作る力(Text-to-Image)と画像を直す力(Image Editing)を比べる定番のベンチマークです。2枚の匿名画像を人間が見比べて投票するEloレーティングに加えて、1枚あたりの料金や生成速度も比較できます。
結果
- Text-to-Image(画像生成 v2.1):1位 OpenAI GPT Image 2.6 Sunburst (max)(約1,261 Elo)、2位 GPT Image 2.5 Sunburst (max)(約1,229 Elo)、3位 GPT Image 2.6 Flare (max)(約1,227 Elo)、4位 Microsoft AI MAI-Image-2.7(約1,214 Elo)、以下 Kling Image 4.0(約1,180 Elo)、Google Nano Banana 2.1(約1,176 Elo)などが続きます
- Image Editing(画像編集 v2.1):1位 Microsoft AI MAI-Image-2.7(約1,215 Elo)、2位 OpenAI GPT Image 2.6 Sunburst (max)(約1,211 Elo)、3位 GPT Image 2.6 Flare (max)(約1,205 Elo)
感想
文章系ではAnthropicやGoogleが強く競り合っていますが、画像生成の分野ではOpenAI(GPT Image 2.6系)が頭ひとつ抜けているのが印象的です。一方で、既存の画像を指示どおりに直す「編集」ではMicrosoftのMAI-Image-2.7が僅差で1位に立っており、一から描くか・手直しするかで強いモデルが変わるのが面白いところです。
今後のベンチマークはどう変わりそう?(予想)
ここからは、2026年11月現在の流れをもとにした予想です。今後は「1問1答で正解を当てるテスト」よりも、「実際の仕事道具を使って最後までやり切れるか」「料金と待ち時間に見合うか」を測るテストが中心になりそうです。
GPQA DiamondやSWE-bench Verifiedのように95%前後まで埋まったテストは、少しずつ卒業していくでしょう。その代わりに、SWE-bench ProやAgent Arena Index、Terminal-Benchのような「実務に近い難題」と「コスト効率」をセットで見る指標が主流になりそうです。
ポイント
ここまでのベンチマーク一覧から見えてくる、今のAI選びのポイントを整理します。
良い点
- 目的別に強みがはっきりしてきた。総合力や実務のClaude、会話の自然さや自律開発コスパのGemini、理系推論のGPTと、得意分野が見分けやすいです。
- 中位モデルでも最上位に迫る性能が出るようになった。Gemini 4 Neonのように、コストを抑えたモデルが総合上位に入る例が増えています。
- 実務やエージェント作業を測る新しいテストが整ってきた。Vals IndexやAgent Arenaなど、実際の使い勝手に近い指標が増えています。
悪い点
- 定番テストの多くが飽和して差が見えにくい。GPQA Diamond(約97%)やSWE-bench Verified(95%超)は満点に近く、比較の参考になりにくいです。
- ツールや設定の条件で数字が変わりやすい。「xhigh」設定や専用ツール(ハーネス)の有無でスコアが動くため、数字の単純比較には注意が必要です。
- データ汚染やテスト不備の課題が残る。公開済みの問題はAIが学習で覚えてしまう懸念があり、非公開テストは第三者が再現確認しにくいジレンマがあります。
まとめ
2026年11月時点の有名AIベンチマーク8種を並べてみると、どのテストでも1社が独占しているわけではなく、総合・会話・実務・開発・画像でトップが入れ替わっています。9割超えの古い数字だけに頼らず、「自分が使いたい作業に近いテスト」と「使うツールとの相性」を見てAIを選ぶのがおすすめです。
ネット上の声
開発者コミュニティ「Hacker News」の議論から、AIベンチマークの現状や信頼性に対する反応を日本語で要約しました(2026年11月19日確認)。
- 評価の良さに加えて応答の速さが効いている。onlyrealcuzzo氏は、Vals IndexやArtificial Analysisの結果に触れつつ、品質に対してレイテンシ(応答の待ち時間)が優れている点も実利用では重要だと見ています。(HN:onlyrealcuzzo氏)
- 複数テストのスコア差が縮まると安心感がある。lanthissa氏は、Terminal-BenchとSWE-benchのスコアの開きが小さくなった点を挙げ、誇張ではない着実な改善の目安として評価しています。(HN:lanthissa氏)
- モデルだけでなく開発ツールの差が大きい。rootusrootus氏は、同じClaude Opus 5.5を使っていても、Claude CodeとCopilotでは体感の出来が大きく違い、モデルを包むツール(ハーネス)の重要性を指摘しています。(HN:rootusrootus氏)
- 順位表より速度と相性を自分で試すべき。IshKebab氏は、ベンチマークで上位のモデルよりも実際は別モデルの方が圧倒的に速く話しやすい場合があり、主要2〜3社を自分で試すのが一番確実だと書いています。(HN:IshKebab氏)
- 非公開コードのベンチマークは再現できない。traceroute66氏は、企業から借りた非公開プログラムを使うテストについて、第三者が中身を確認できないなら「信じてください」と言うのに近いと疑問を呈しています。(HN:traceroute66氏)
- SWE-bench Verifiedにもテスト側の不備があった。vintagedave氏は、監査によって一部の問題に正しい修正を弾いてしまうテスト不備が見つかった点を取り上げ、完璧な指標ではないと指摘しています。(HN:vintagedave氏)
- 学習データに問題が混ざる影響は避けにくい。adityamwagh氏は、モデルが学習時に問題を見ているほど有利になりやすい点について、やはりデータ汚染の影響は大きいとコメントしています。(HN:adityamwagh氏)
- これからはSWE-bench Proを重視すべき。djoldman氏は、データ汚染の影響が比較的少ないとされるSWE-bench Proの結果を報告する動きに賛同しています。(HN:djoldman氏)
- テストが飽和するたびに基準を変えるのも違和感。1a527dd5氏は、スコアが天井に近づくたびに新しいテストへ移る流れに対し、ゴールポストを動かしているようにも見えると述べています。(HN:1a527dd5氏)
- 実際の仕事にはテストのような正解がない。verdverm氏は、人間の仕事の多くはベンチマークのようにすぐ正解が返る環境ではないため、テストの点数ほど急激な置き換えは起きていないと分析しています。(HN:verdverm氏)

ベンチマークの順位は便利だけど、数字の「測定条件」を見落とさないでほしいにゃ。思考レベルを最大にした結果なのか、どのツールと組み合わせたのかで点数は変わるにゃ。最後は自分がよく使う作業で2〜3個のAIを実際に比べてみるのが一番確実だにゃ。
調査日:2026年11月19日(日本時間)
主な参照先:Artificial Analysis / Arena(lmarena.ai) / Vals AI / SWE-bench / Terminal-Bench
コメント